


Kronehoefstraat 85
5612 HL Eindhoven
BTW NL863902509B01
Fundamentele beperkingen van gedachten over AI-agents binnen legacy software SaaS
qw
vc
mshm



De AI-assistent in je CRM doet weinig omdat het systeem eronder nooit gebouwd is om de context van een beslissing vast te leggen. Het bewaart het resultaat, niet de afweging die eraan voorafging. Zonder die context kan geen enkele AI-agent, ook niet die van je leverancier, verder komen dan een generiek antwoord.
Je hebt de AI-agent in HubSpot of ClickUp aangezet. De eerste week typte je elke ochtend een vraag in het zoekvak. Na een maand doe je dat niet meer.
Dat is geen uitzondering. In 2024 gebruikte 22,7 procent van de Nederlandse bedrijven met 10 of meer medewerkers AI-technologie, een stijging ten opzichte van het jaar ervoor (CBS, 2025). De meeste van die bedrijven proberen de ingebouwde assistent eerst, omdat hij al in het pakket zit waar ze al voor betalen.
Softwareleveranciers bouwen die assistenten in hoog tempo bij. HubSpot breidde in 2025 zijn Breeze-assistenten uit en voegde meerdere nieuwe AI-agents toe aan het platform (HubSpot, 2026). ClickUp, Jira en de meeste branchepakketten volgen hetzelfde patroon: een chatvak erbij, een paar automatische samenvattingen, klaar.
Je gebruikt het een paar keer, het antwoord is generiek, en je gaat terug naar hoe je het altijd deed. Daarna zitten er drie gevoelens tegelijk: dit had meer moeten doen, misschien gebruik ik het verkeerd, en moet ik dan maar wachten op de volgende release.
Geen van de drie klopt. De pijn zit niet in "AI werkt niet". De pijn zit in niet weten waarom het niet werkt, en daardoor geen beslissing kunnen nemen over wat je dan wel doet. Dat is precies waar dit artikel verandering in brengt.
Herkenbaar is ook het moment erna: een collega vraagt hoe het met de AI-proef gaat, en het antwoord is een schouderophalen. Niemand heeft de stekker eruit getrokken. De tool staat gewoon stil ergens in een werkbalk, en het gesprek erover verdwijnt vanzelf van de agenda.
De oorzaak zit niet in het AI-model. GPT, Claude of Gemini maken geen verschil wanneer ze op dezelfde onderliggende data draaien. De oorzaak zit in hoe je CRM, je ticketsysteem of je ERP is gebouwd, jaren voordat iemand aan agents dacht.
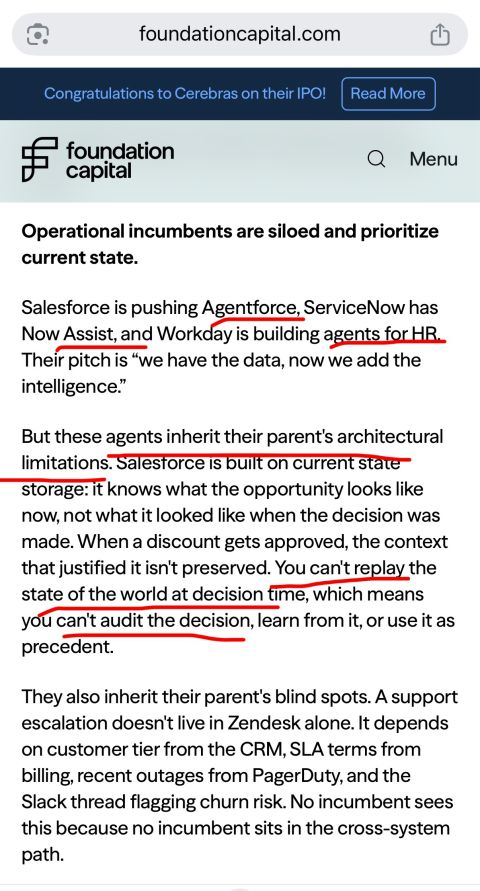
Investeerder Foundation Capital legt dit scherp uit in een analyse van de architectuur achter grote SaaS-platforms: "Salesforce is built on current state storage: it knows what the opportunity looks like now, not what it looked like when the decision was made" (Foundation Capital, 2026). Vertaald naar jouw CRM: het systeem onthoudt dat de korting is goedgekeurd, niet waarom, door wie, of welke uitzondering daarvoor gold.
Bijna elk bedrijfssysteem dat je gebruikt is een system of record. Dat is geen ontwerpfout, het was voor mensen lang genoeg. Een collega die de context mist, loopt naar het bureau ernaast en vraagt het. Een AI-agent kan dat niet.
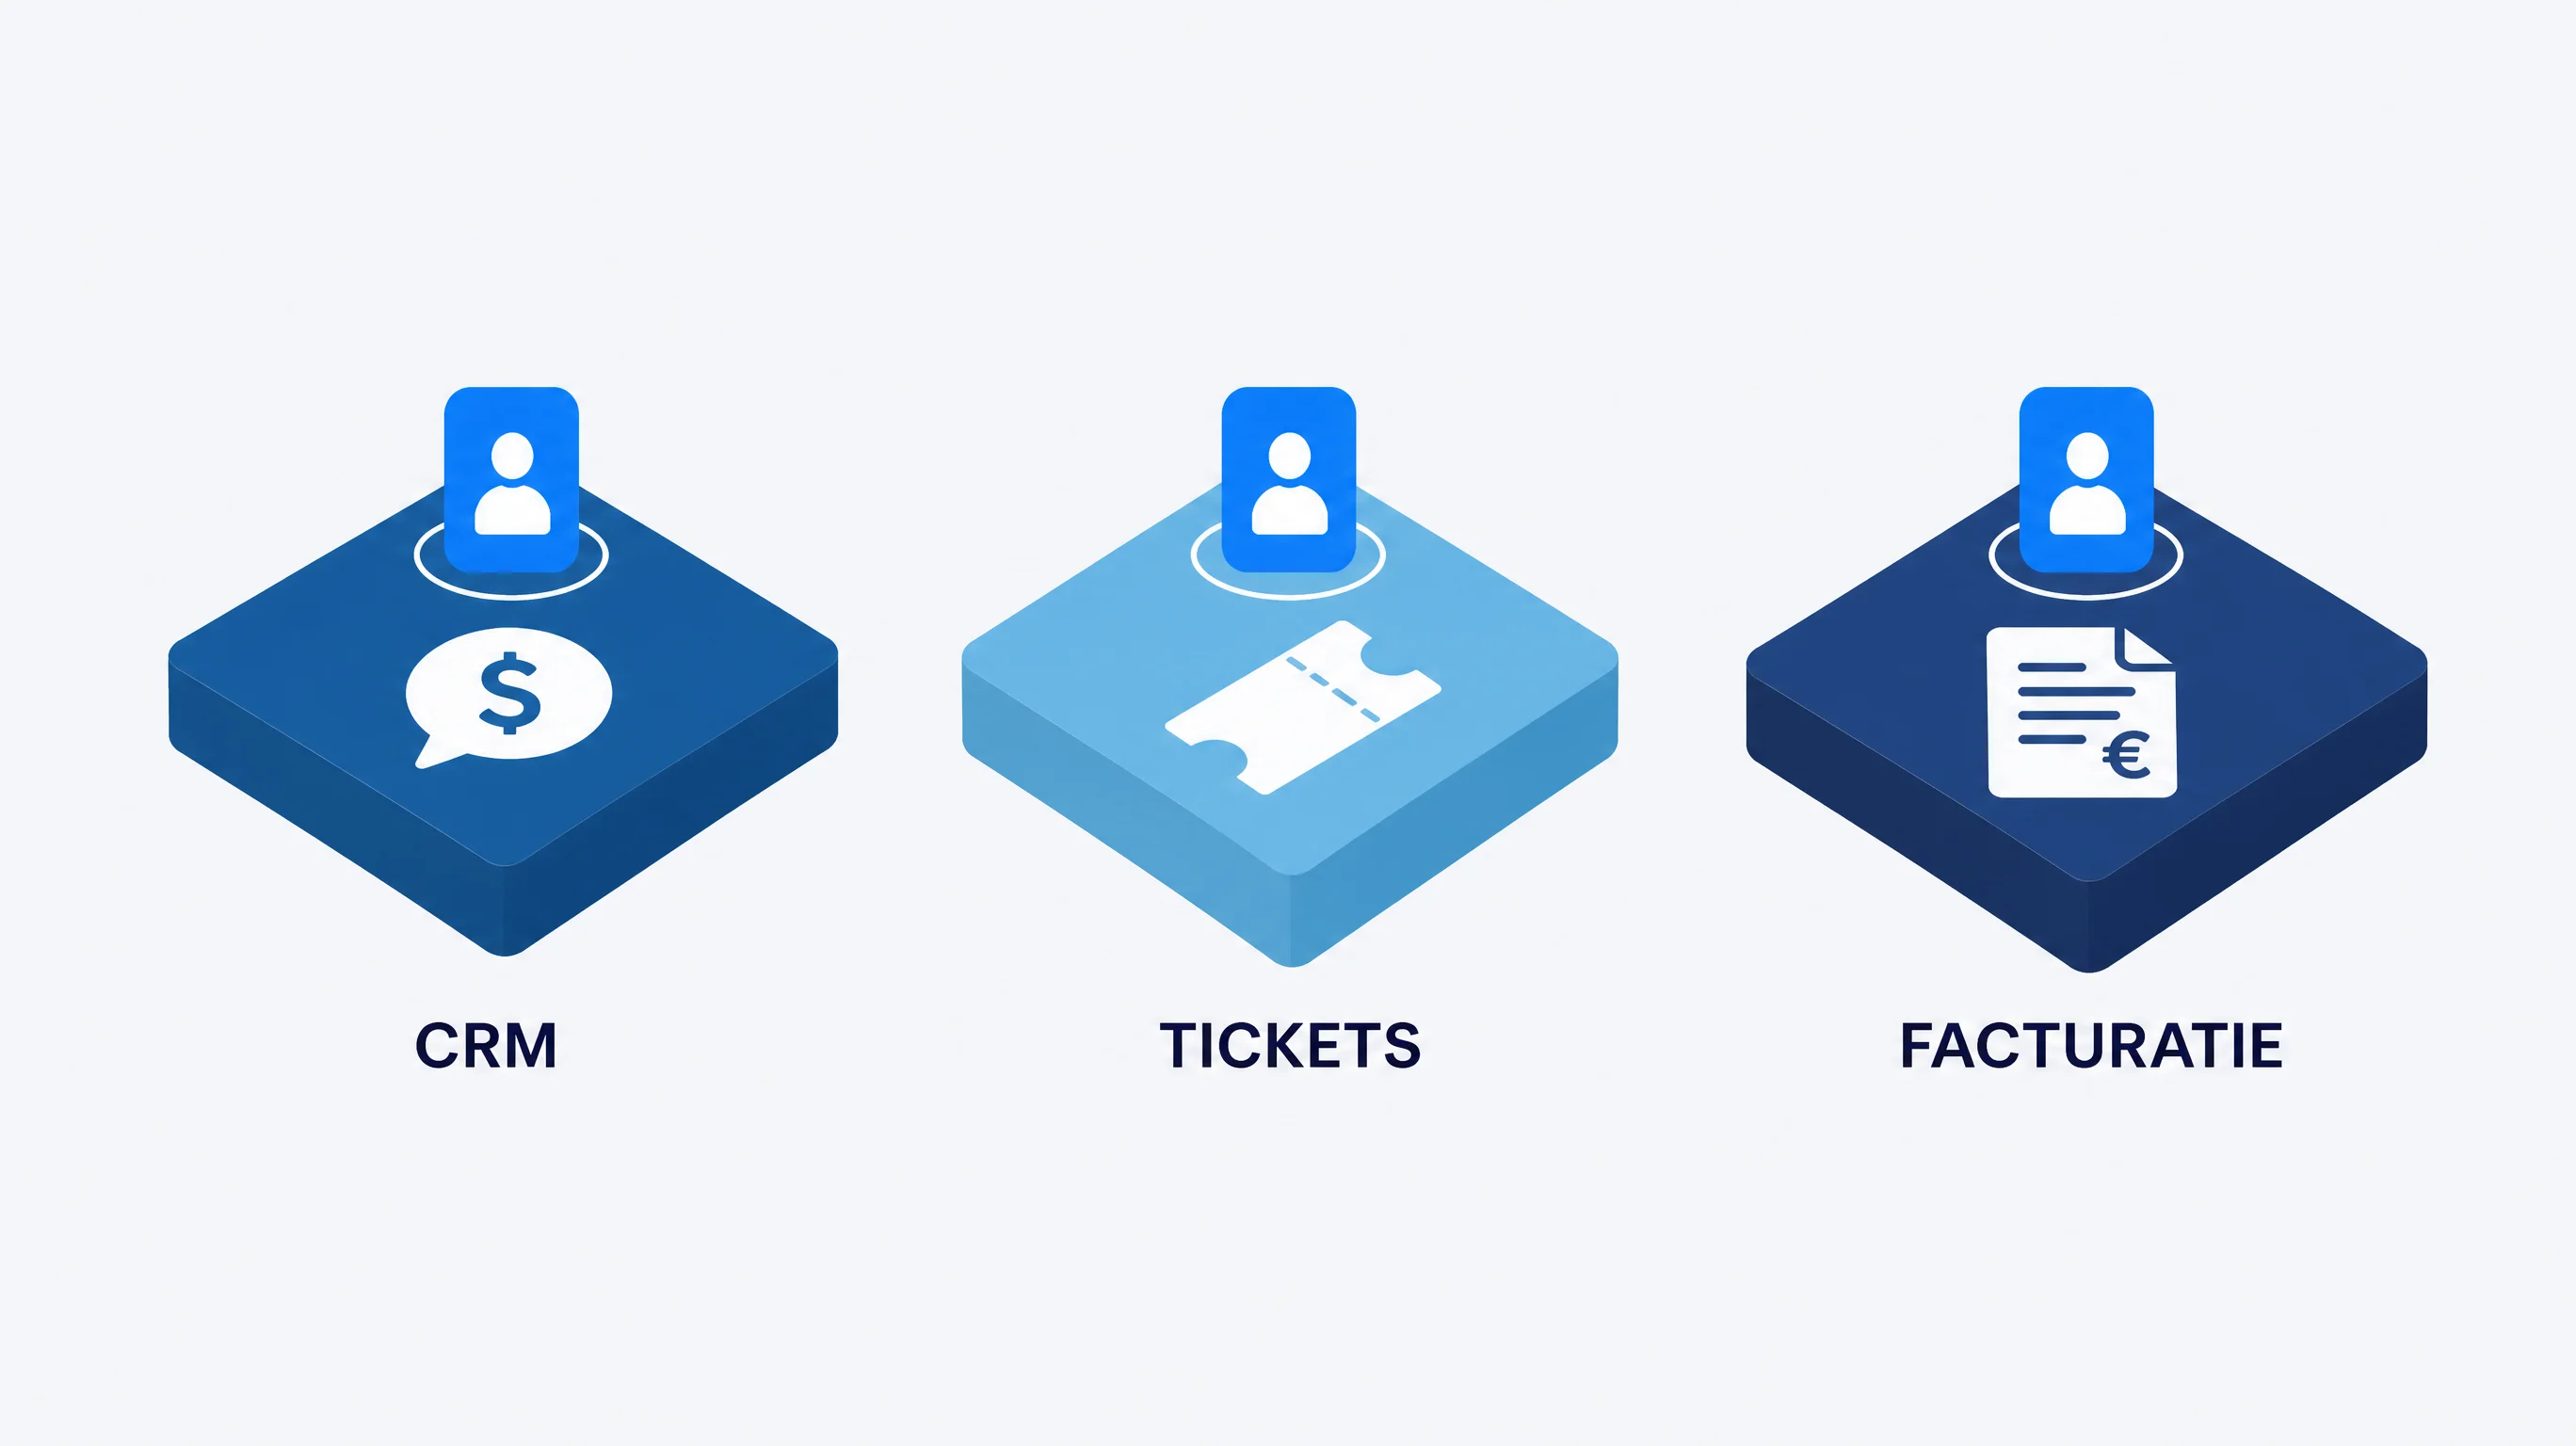
Dit raakt niet alleen je CRM. Je ticketsysteem bewaart de oplossing van een storing, niet de reeks tussenstappen die daartoe leidde. Je boekhoudpakket bewaart het definitieve bedrag op de factuur, niet de onderhandeling die eraan voorafging. Elk van die systemen is uitstekend in zijn eigen taak, en geen van allemaal is gebouwd om een agent iets te leren van hoe die taak tot stand kwam.
Een agent die een beslissing moet nemen, moet eerst kunnen toetsen hoe eerdere, vergelijkbare beslissingen zijn genomen. Foundation Capital noemt dat spoor de "decision trace": "Agents don't just need rules. They need access to the decision traces that show how rules were applied in the past, where exceptions were granted, how conflicts were resolved, who approved what, and which precedents actually govern reality" (Foundation Capital, 2026).
Zonder dat spoor kan een agent drie dingen niet: de beslissing herleiden, haar toetsen aan wat er daarna gebeurde, en haar als precedent gebruiken voor het volgende, vergelijkbare geval. Hij kan alleen nog gissen op basis van de huidige staat, en dat levert het generieke antwoord op dat je al kent.
De volgende release lost dit niet op. Een leverancier die een agent bovenop zijn eigen product bouwt, bouwt die agent met de data die het product al verzamelt, en dat is de uitkomst, niet de context.
"These agents inherit their parent's architectural limitations", schrijft Foundation Capital (2026). De AI-assistent in je CRM of je ticketsysteem ziet alleen wat er in dat ene systeem gebeurt. Een escalatie hangt zelden aan één systeem: ze hangt aan het CRM, de facturatie, de monitoring en het gesprek erover tegelijk, en dat antwoord ligt per definitie over systemen heen.
Venture-partner Gaurav Tewari beschrijft hetzelfde probleem vanuit de kant van de inzet: een assistent die op zichzelf een taak uitvoert, loopt vast zodra hij een stap buiten zijn eigen applicatie nodig heeft. "Agents create durable value when they improve measurable outcomes inside real workflows, not when they simply automate isolated tasks" (Forbes, 2026).
Dat is geen kritiek op je leverancier. Het is een grens die in het ontwerp zit. Wachten op een release die deze grens oplost, is wachten op een systeem van record dat zichzelf verandert in een systeem van context. Dat gebeurt niet.
Je ziet dit patroon bij vrijwel elke grote softwarecategorie terug. Een CRM-leverancier bouwt een agent die goed is in dealstatussen, maar niets weet van de supportgeschiedenis die bij hetzelfde account hoort. Een ticketsysteem bouwt een agent die tickets samenvat, maar niets weet van het contract dat de klant heeft getekend. Beide agents zijn technisch knap, en beide missen de helft van het verhaal.
De uitweg ligt niet in een ander CRM of een duurdere licentie. Hij ligt in een laag die je zelf bouwt, bovenop de systemen die je al hebt.
Gebruik je bestaande software zoals hij bedoeld is: als administratie. Daarnaast leg je, op het moment dat het werk gebeurt, de context vast die er nu nog verloren gaat. Waarom is deze korting goedgekeurd. Welke uitzondering gold hier. Wat heeft de klant eerder gezegd dat niet in een notitieveld past. Die context bouw je op als een kennislaag die je zelf bezit, niet als een export die bij je leverancier blijft staan.
Softwareleveranciers bewegen zelf dezelfde kant op: HubSpot voegde in 2025 meer dan 15 nieuwe AI-agents toe aan zijn eigen platform (HubSpot, 2026). Dat bevestigt het probleem meer dan het oplost: elke leverancier bouwt zijn eigen, afgesloten laag. Bouw jij die laag zelf, dan werkt ze over je systemen heen en kun je de agents die je daarop bouwt ook inzetten zodra je van CRM wisselt.
Dat is het verschil tussen een laag die van jou is en een functie die bij je leverancier hoort. Wat je dit kwartaal voor sales bouwt, levert volgend kwartaal ook iets op voor marketing of operations, omdat de context niet per systeem vastzit maar centraal staat.
Praktisch betekent dit meestal niet meteen een compleet nieuw systeem. Het begint vaak met een paar velden en notities die je nu al vastlegt, maar gestructureerd op een plek die niet aan één leverancier vastzit. Pas daarna bouw je er de agent bovenop die deze context ook echt gebruikt in plaats van alleen bewaart.
Begin niet bij alle systemen tegelijk. Dat patroon is al eerder misgegaan: 95 procent van de generatieve AI-pilots in bedrijven leverde in 2025 geen meetbaar rendement op, vaak omdat de scope te breed lag en nergens goed op aansloot (Fortune over MIT-onderzoek, 2025).
Kies in plaats daarvan één proces waar een beslissing vaak terugkomt: een kortingsgoedkeuring, een escalatie, een intakebeoordeling. Leg bij dat ene proces de context vast op het moment dat iemand de beslissing neemt, niet achteraf uit het geheugen.
Bouw daar een eerste stuk workflow-automatisering op met een context window dat die vastgelegde afwegingen meeneemt, en laat een mens de eerste weken elke uitkomst controleren. Breid pas uit naar een tweede proces als het eerste zonder correcties draait.
Dit kost tijd en een paar iteraties voordat het echt iets oplevert. Dat is geen omweg, het is de enige manier waarop de volgende agent die je bouwt sneller gaat dan de vorige, omdat hij op dezelfde kennisbank voortbouwt in plaats van weer bij nul te beginnen.
Meet na de eerste weken twee dingen: hoe vaak de agent een uitkomst voorstelt die een mens zonder correctie overneemt, en hoeveel tijd dat per geval scheelt. Beide cijfers samen vertellen je of je klaar bent voor het tweede proces, of dat het eerste eerst meer iteraties nodig heeft.
Verwacht geen rechte lijn omhoog. De eerste weken corrigeer je vaker dan je zou willen, en dat is precies de bedoeling: elke correctie is een stukje context dat de agent de volgende keer wel heeft. Na een paar cycli neemt het aantal correcties merkbaar af, en dat is het signaal om het tweede proces te starten.

Omdat het systeem eronder is gebouwd om de uitkomst van een beslissing vast te leggen, niet de afweging die eraan voorafging. De assistent kan alleen werken met wat er is opgeslagen, en dat is de huidige staat, niet de context.
Nee. Het is geen gebruiksfout en geen instelling die je over het hoofd ziet. De beperking zit in de architectuur van het systeem: het bewaart nooit de context die een agent nodig heeft om verder te komen dan een generiek antwoord.
Een system of record bewaart de huidige staat: de dealstatus, het laatste ticket, de factuur. Een system of context bewaart hoe die staat tot stand kwam: de afweging, de uitzondering, het gesprek eromheen. De meeste bedrijfssoftware is het eerste, zelden het tweede.
Niet structureel. Een leverancier bouwt zijn agent met de data die zijn eigen product al verzamelt, en erft daarmee dezelfde architectuur en dezelfde blinde vlekken. Een release kan de interface verbeteren, niet het ontbrekende spoor aanvullen.
Nee, en dat lost het probleem ook niet op: het volgende pakket heeft dezelfde architectuur. Gebruik je huidige systemen als administratie en bouw de context-laag ernaast, zodat een overstap later geen nieuw startpunt betekent.
Een kennislaag die vastlegt waarom beslissingen zijn genomen, op het moment dat ze genomen worden, los van welk systeem van record daarbij hoort. Die laag is van jou, herbruikbaar over afdelingen heen, en blijft bestaan als je ooit van tool wisselt.
Kies één proces met een terugkerende beslissing, leg daar de context bij vast, en laat een mens de eerste periode elke uitkomst controleren. Breid pas uit zodra dat ene proces zonder correcties draait.
Reken op meerdere iteraties voordat het eerste proces stabiel draait. Dat is geen tegenvaller: 95 procent van de brede AI-pilots zonder die discipline levert geen meetbaar resultaat op, en een klein, goed afgebakend proces voorkomt dat lot.
Je hoeft niet te wachten tot je softwareleverancier het oplost. Wij bouwen de laag die jouw systemen wel bruikbaar maakt voor agents, bovenop wat je al hebt. Ontdek hoe een eigen AI-laag dit oplost.
Bekijk AI-agents & Procesautomatisering


