


Kronehoefstraat 85
5612 HL Eindhoven
BTW NL863902509B01
Van data rondpompen naar een eigen AI-laag
qw
vc
mshm



Een eigen AI-laag ontstaat niet door nog meer systemen aan elkaar te knopen, maar door een AI-agent rechtstreeks toegang te geven tot je brondata, op het moment dat hij die nodig heeft. Dat werkt het best als je bedrijf de ambitie heeft om AI als eigen capability te bouwen. Zonder die ambitie is kant-en-klare pakket-AI vaak de verstandigere keuze.
Je bedrijf draait waarschijnlijk op vijf tot tien systemen: boekhouding, CRM, projectmanagement, e-mail, en misschien een branchepakket voor vastgoed, bouw of recruitment. Geen van die systemen praat vanzelf met de andere.
Het gevolg is bekend terrein. Iemand zoekt een adres op in het CRM en typt het over in de boekhouding. Een projectstatus wordt in drie tools bijgehouden, en bij twijfel wint het systeem dat het laatst is bijgewerkt. Vijftien jaar lang was het antwoord op dit probleem steeds hetzelfde: synchroniseer alles naar één centraal pakket.
Dat antwoord was niet fout. Synchronisatie bestaat om mensen minder tijd te laten verliezen aan overtypen en opzoeken, niet als doel op zich. Het probleem ontstaat zodra bedrijven de synchronisatie zelf tot doel maken, in plaats van het onderliggende probleem: mensen die tijd verliezen aan werk dat een systeem zelf zou moeten regelen.
De cijfers laten zien hoe wijdverspreid dit patroon is. De gemiddelde organisatie beheert 897 applicaties, waarvan slechts 29% daadwerkelijk gekoppeld is (MuleSoft Connectivity Benchmark Report, Salesforce, 2025). Voor een MKB-bedrijf met vijf tot tien systemen is die verhouding vaak nog schever: er is geen IT-afdeling die alles stelselmatig aan elkaar knoopt.
Tegelijk groeit het gebruik van AI in het Nederlandse bedrijfsleven snel. In 2024 gebruikte 22,7% van de bedrijven met tien of meer medewerkers minstens één AI-technologie, een stijging van bijna negen procentpunt ten opzichte van 2023 (CBS, AI-monitor 2024). Die groei verandert de businesscase achter synchronisatie fundamenteel.
Dat is ook de reden dat de reflex "we moeten gewoon integreren" vaak de verkeerde vraag oproept. De juiste vraag is niet hoe je alles aan elkaar knoopt, maar welk deel van je data een vaste plek nodig heeft en welk deel prima bij de bron kan blijven liggen totdat iemand, of iets, erom vraagt.
Synchronisatie was altijd een middel om mensen efficiënter te maken, nooit het doel zelf. Zodra een AI-agent zelfstandig data kan ophalen op het moment dat hij die nodig heeft, vervalt een groot deel van de reden om alles vooraf op één plek te verzamelen.
Wat deze reflex ook verbergt, is de prijs van de koppelingen zelf. Elke directe verbinding tussen twee systemen moet onderhouden worden zodra een van de twee een update krijgt, een veldnaam wijzigt, of een leverancier zijn API versie opnieuw uitbrengt. Bij twee systemen is dat overzichtelijk. Bij zes systemen groeit het aantal mogelijke verbindingen sneller dan de meeste MKB-teams beseffen, en onderhoud dat niemand expliciet heeft begroot, wordt stilletjes de grootste kostenpost van je systeemlandschap.
Wil je systemen beter laten samenwerken, dan zijn er in de praktijk drie routes. Ze staan niet gelijkwaardig naast elkaar: het is eerder een trechter, van de vertrouwde maar dure route, via een zwaardere tussenstap, naar de route die wij voor de meeste MKB-bedrijven aanraden, mits de nadelen bewust worden afgedekt.
Dit is de route die de meeste bedrijven kennen, omdat softwareleveranciers hem actief aanbevelen. Elke nieuwe koppeling kost opnieuw bouw- en onderhoudstijd, en je koopt jezelf vast bij de leverancier die toevallig "AI" op de feature-lijst heeft staan.
Een datawarehouse is de professionele oplossing voor bedrijven die al precies weten welke vragen ze structureel aan hun data willen stellen. Voor een MKB-bedrijf dat nog aan het ontdekken is welk proces de meeste tijd kost, is dit zelden de eerste stap. Het is stap drie, niet stap een. IBM omschrijft zo'n tussenlaag als een manier om systemen los te koppelen zodat ze onafhankelijk van elkaar kunnen veranderen (IBM, 2025), precies de rol die Route B vervult.
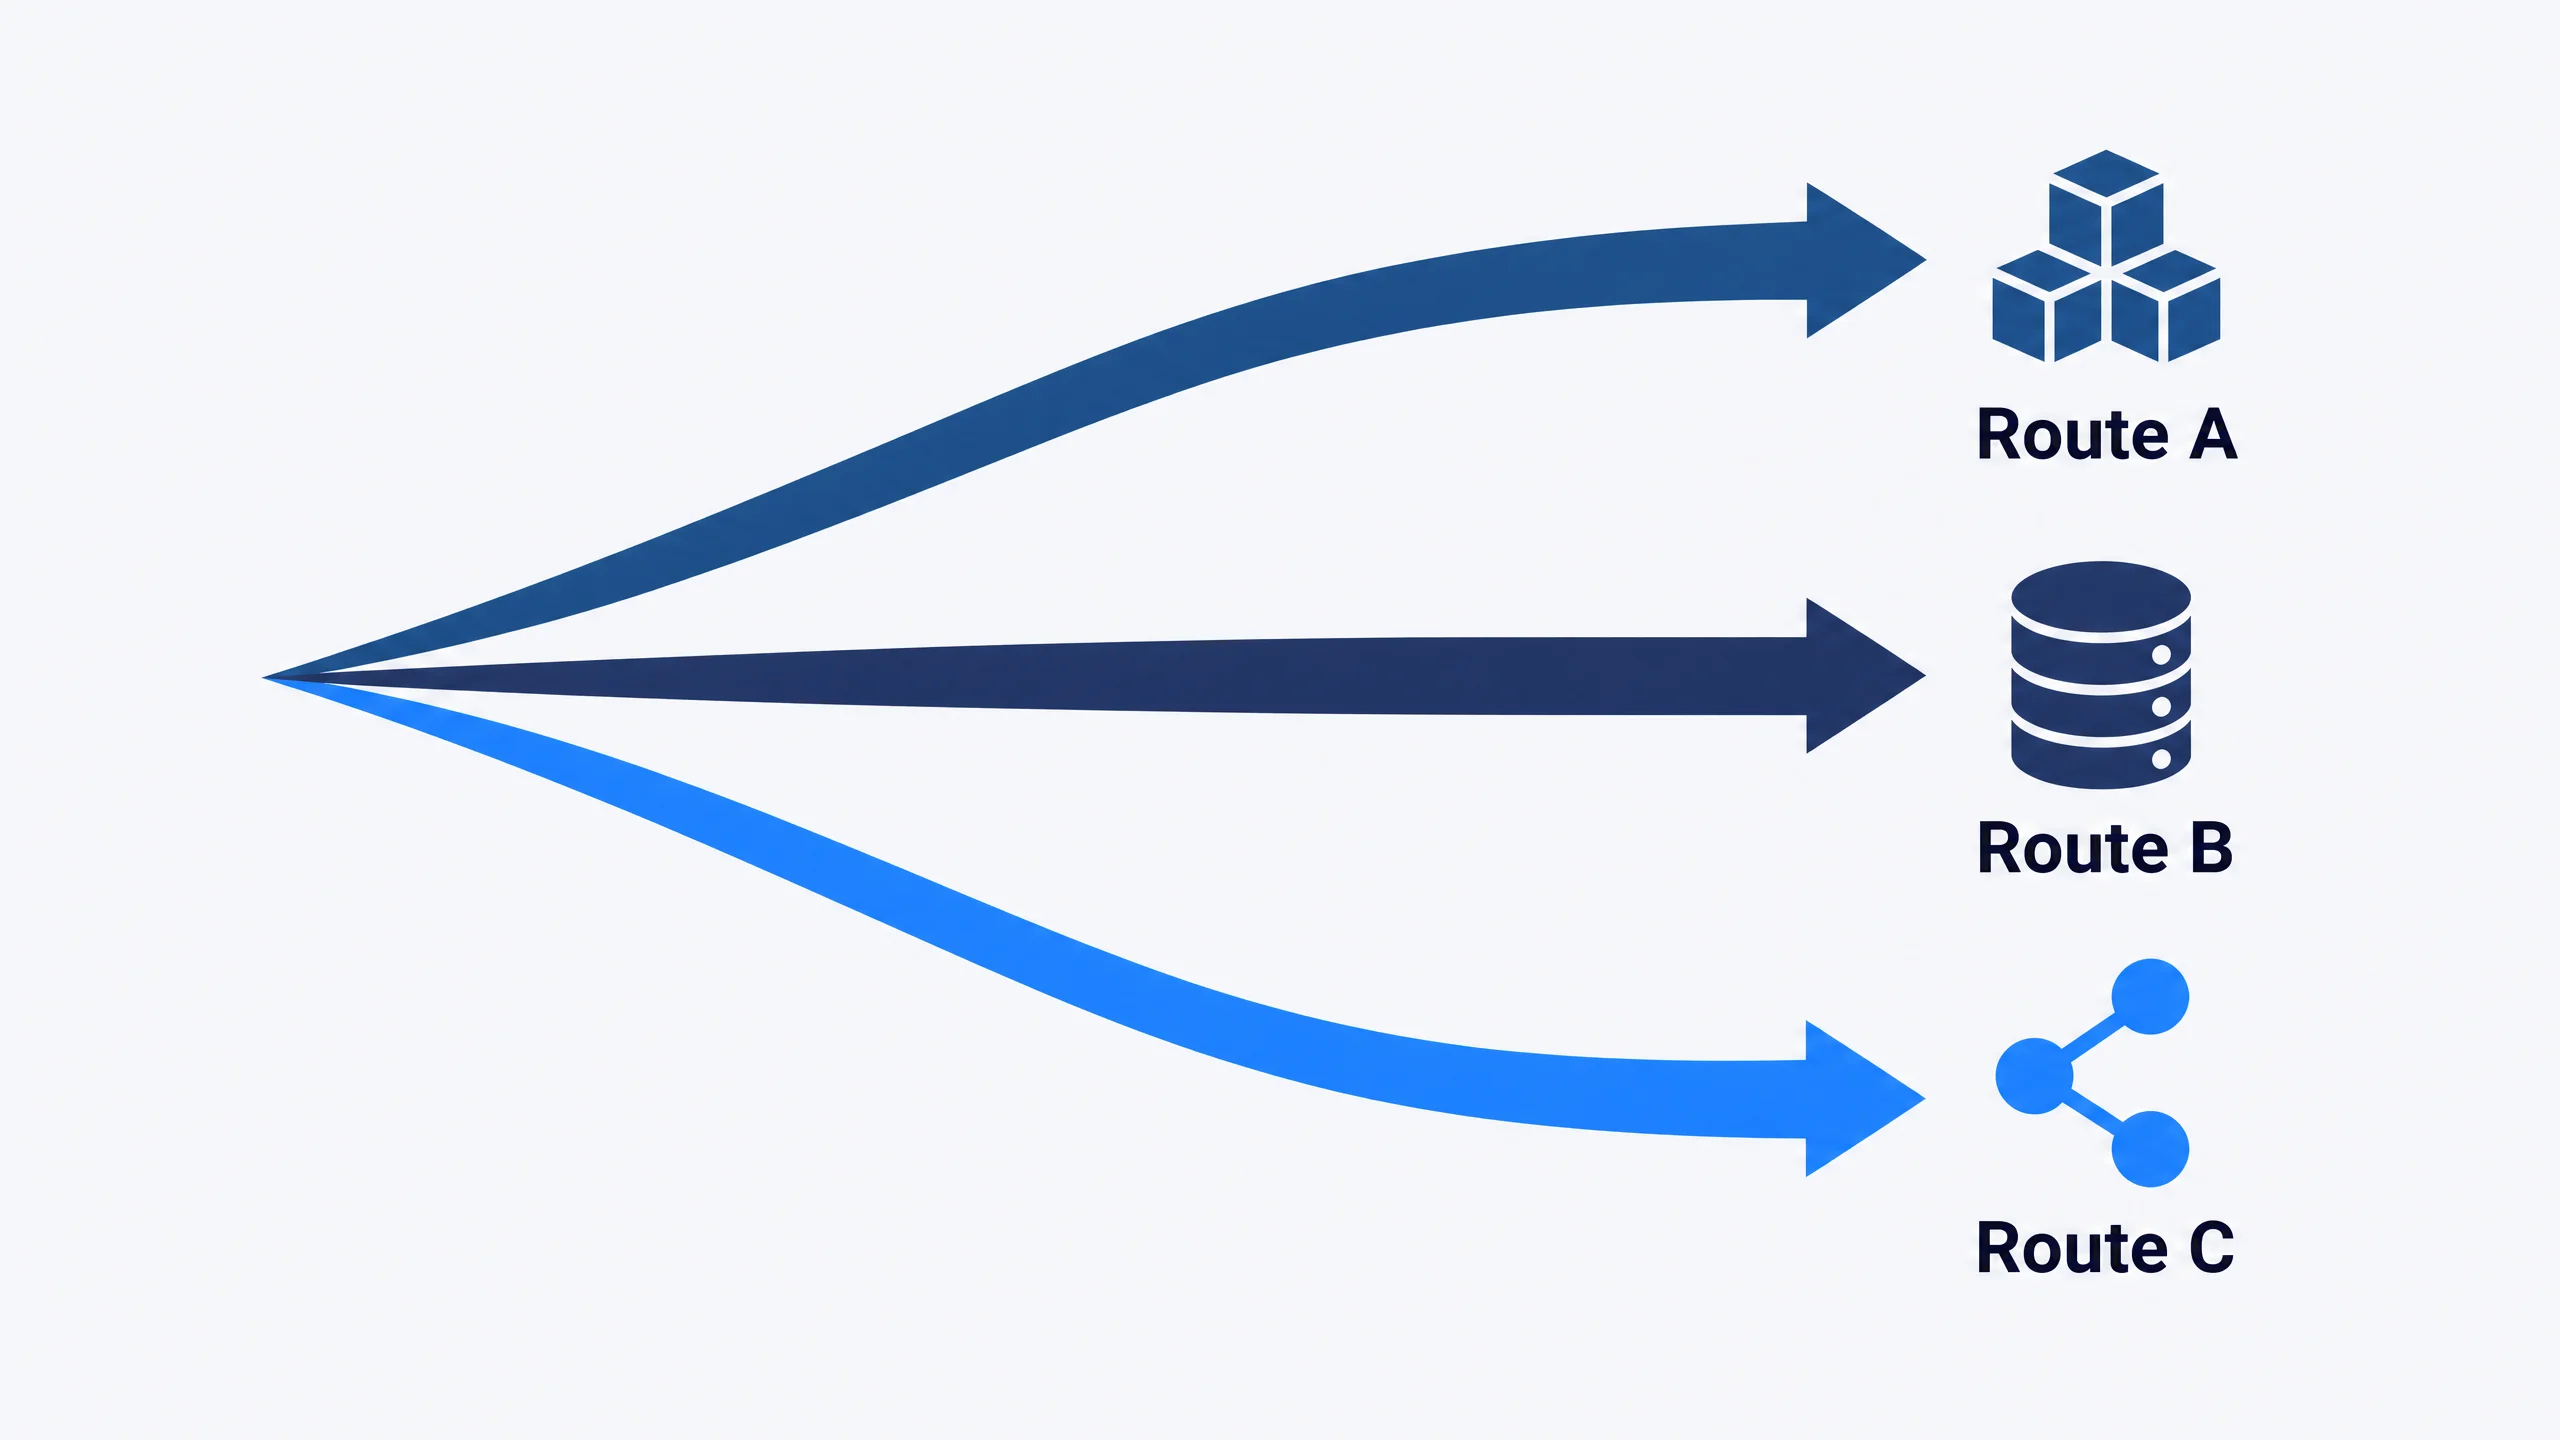
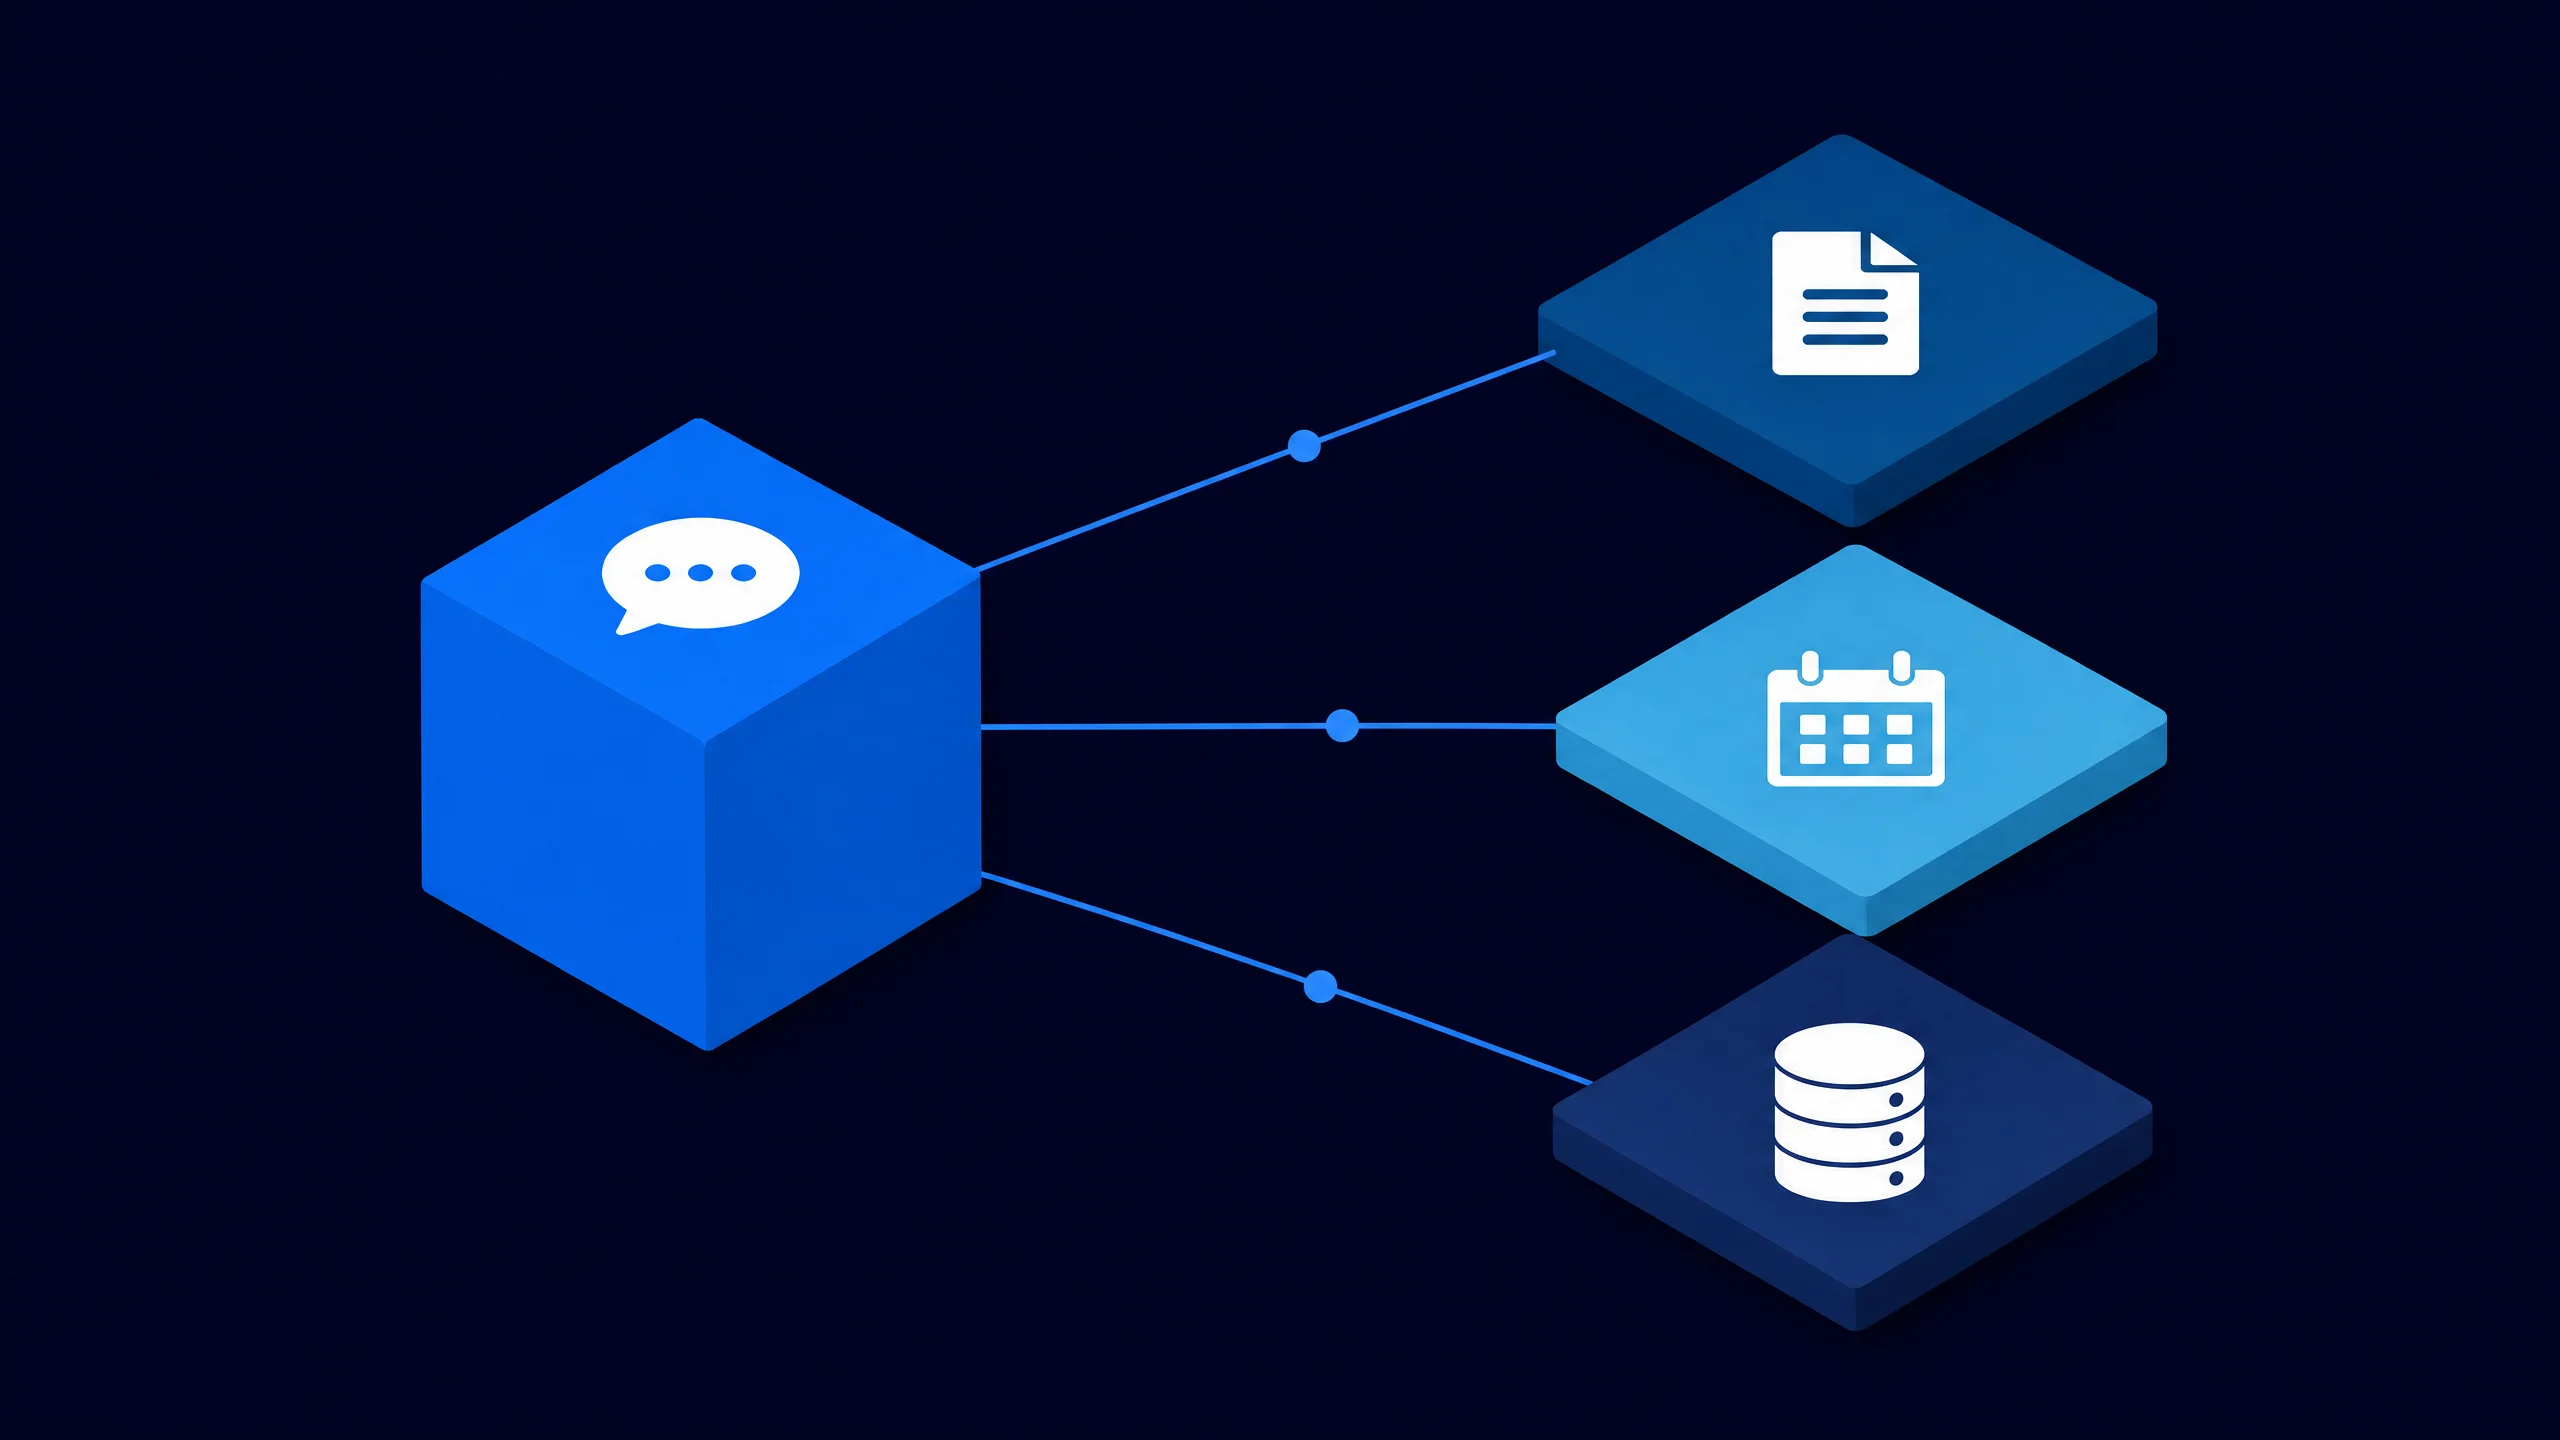
In deze route krijgt een agentic AI-systeem toegang tot je bronsystemen zelf, en haalt het de gevraagde data op het moment van de vraag op via tool calling. Dat gebeurt vaak via het Model Context Protocol (MCP), een open standaard om AI-systemen te koppelen aan externe tools en databronnen, inmiddels ondergebracht bij de Linux Foundation zodat geen enkele leverancier de standaard alleen bezit (Anthropic, 2025).
Voor een MKB-bedrijf is dat laatste punt niet bijzaak. Een open standaard betekent dat een koppeling die je dit jaar bouwt op basis van het ene AI-model, volgend jaar met een ander model blijft werken, zonder dat je opnieuw moet onderhandelen met een enkele leverancier over de voorwaarden van die koppeling.
Onze SaaS-integratie-aanpak begint daarom met precies deze route te onderzoeken, omdat hij meestal het snelst een werkend eerste resultaat oplevert. Dat betekent niet dat hij zonder nadelen is.
AI-agents die op basis van een taalmodel beslissen welke tool ze aanroepen, zijn per definitie niet volledig voorspelbaar. Een AI-agent die zelfstandig tools aanroept, is in de kern een taalmodel dat herhaaldelijk handelt op basis van omgevingsfeedback (Anthropic, 2024), en dat vraagt om bewust ontworpen grenzen in plaats van blind vertrouwen.
Stel dat een agent bij elke klantvraag live de voorraad, de planning en het CRM raadpleegt, en de antwoorden daaruit combineert: dat is het soort schaalvoordeel waar Route C op mikt, niet als vervanging van mensen maar als vermenigvuldiging van toegang tot informatie. Zodra een agent meerdere bronnen tegelijk combineert tot één samenhangend antwoord, noemen we dat orchestration. Dat werkt alleen betrouwbaar met een human-in-the-loop-stap op het moment dat een antwoord een beslissing met echte gevolgen raakt, niet als losse suggestie achteraf.
Niet elke synchronisatie is een vergissing. Er zijn minstens drie situaties waarin Route A of Route B de juiste keuze blijft, ook als je elders al met AI-agents werkt.
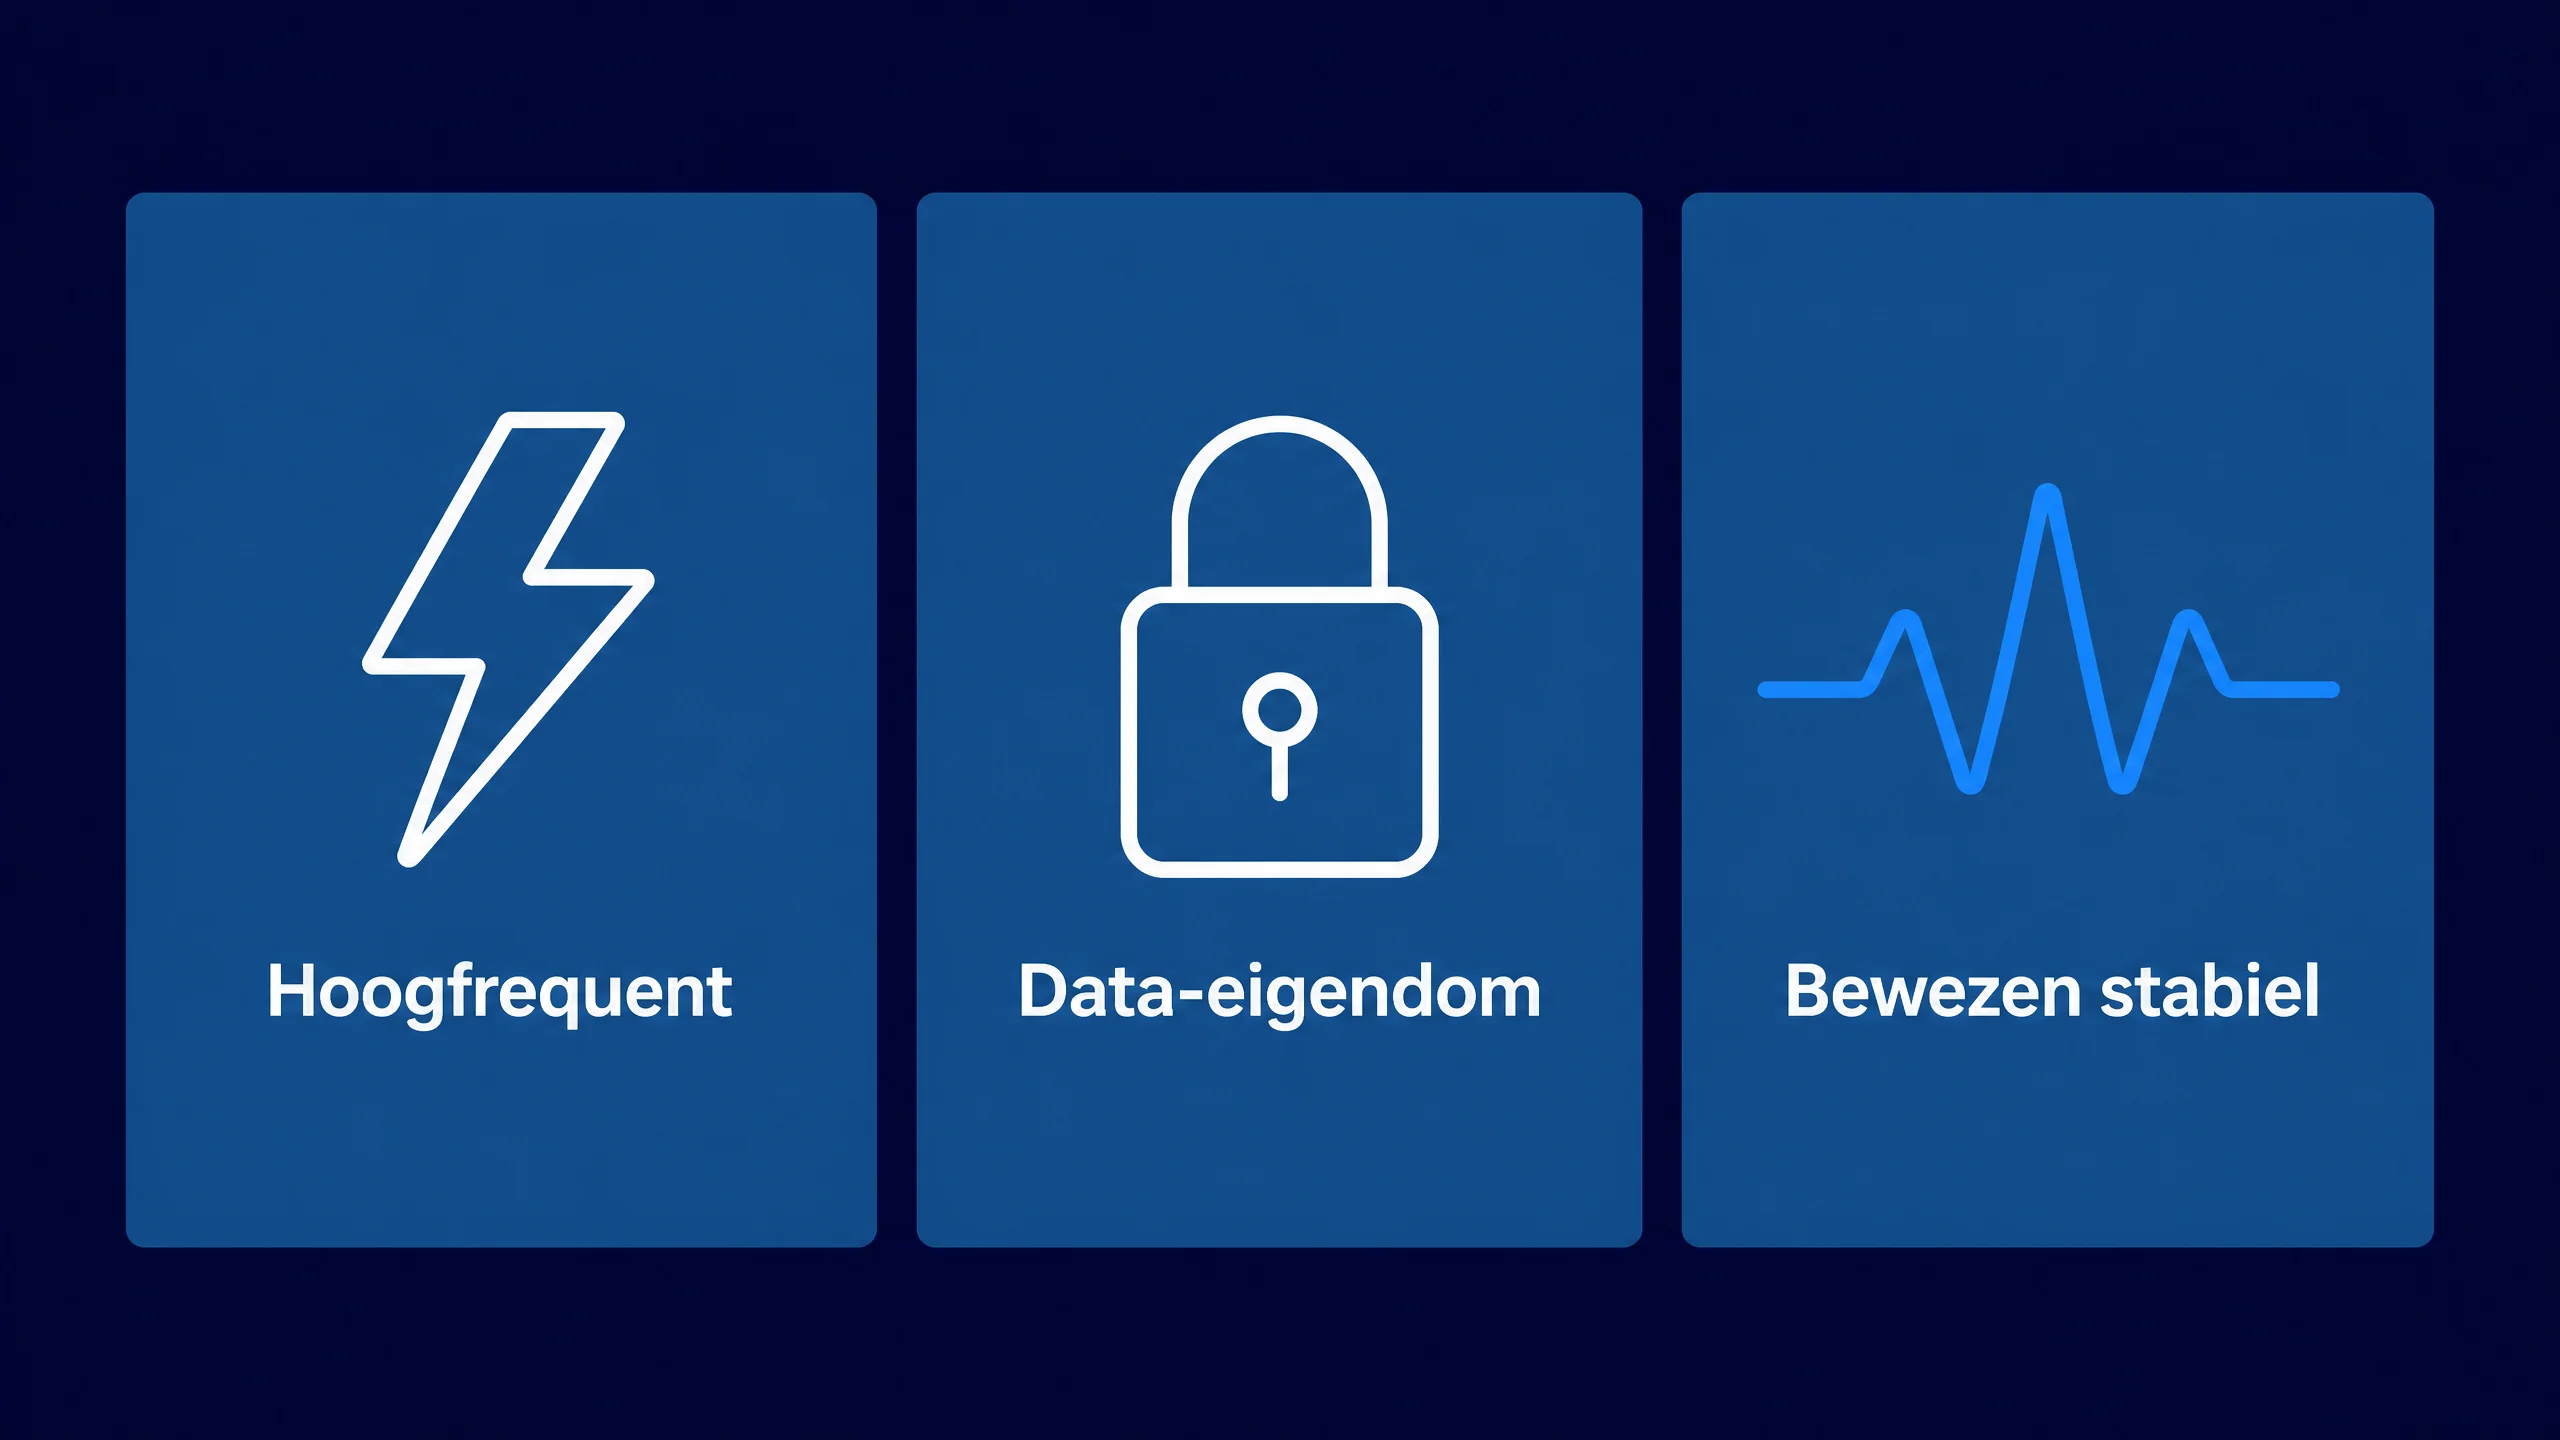
De eerste: hoogfrequente of hoog-volume workloads, zoals een webshop die duizenden orders per uur verwerkt. Live bij de bron ophalen voegt dan latency en kosten per aanroep toe die een vooraf gesynchroniseerde datastroom niet kent.
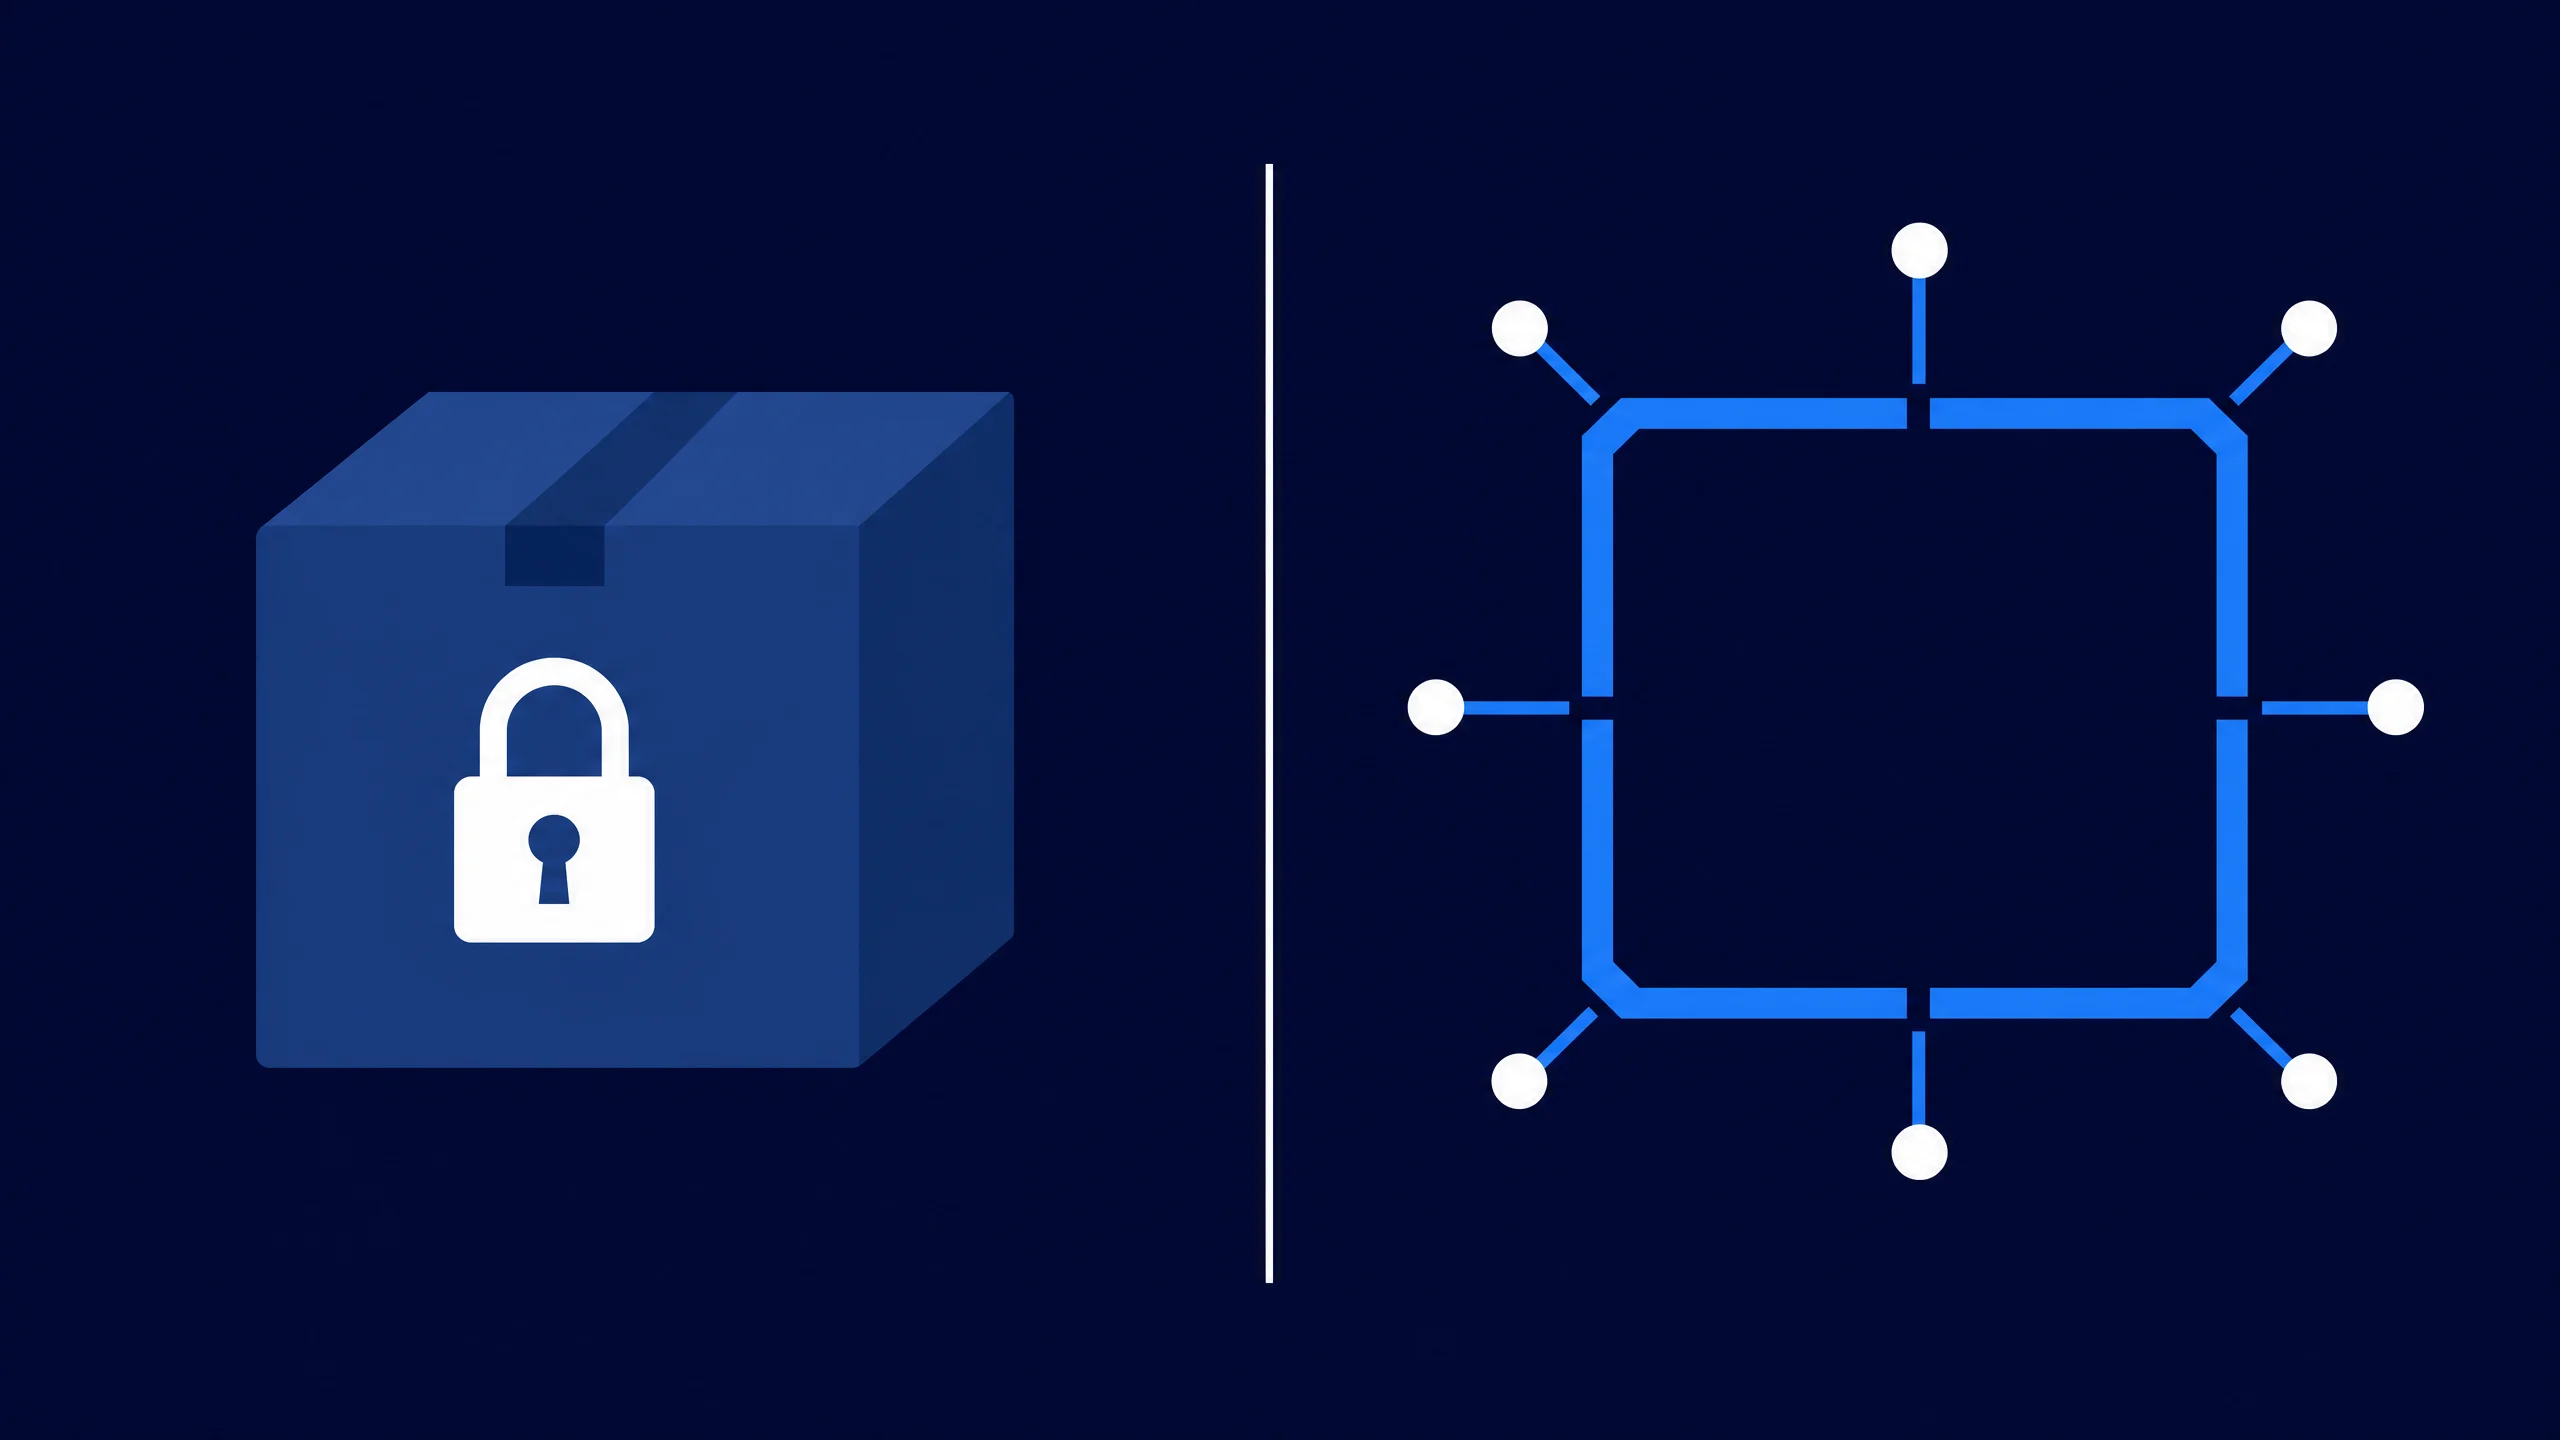
De tweede: data-eigendom en continuïteit. Moet je kunnen garanderen dat historische data intact blijft, ook als een leverancier stopt of een API-contract wijzigt? Dan wil je een eigen kopie van die data, niet alleen een live verbinding naar een systeem dat je zelf niet beheert.
De derde: bewezen, stabiele datastromen die al jaren zonder problemen draaien. Een koppeling vervangen die werkt, puur omdat er een nieuwere aanpak bestaat, is risico zonder winst.
De markt voor integratieplatformen (iPaaS) groeit ondertussen onverminderd: wereldwijd werd de omvang in 2025 geschat op 15,63 miljard dollar, met een verwachte jaarlijkse groei van 24,2% tot 2034 (Fortune Business Insights, 2025). Bedrijven blijven dus fors investeren in klassieke integratie, naast en niet in plaats van agentic AI.
Synchronisatie verdwijnt niet, hij wordt een bewuste keuze in plaats van een reflex. De vraag is niet meer "synchroniseren wij", maar "welk deel van onze data verdient een vaste kopie, en welk deel mag live opgehaald worden".
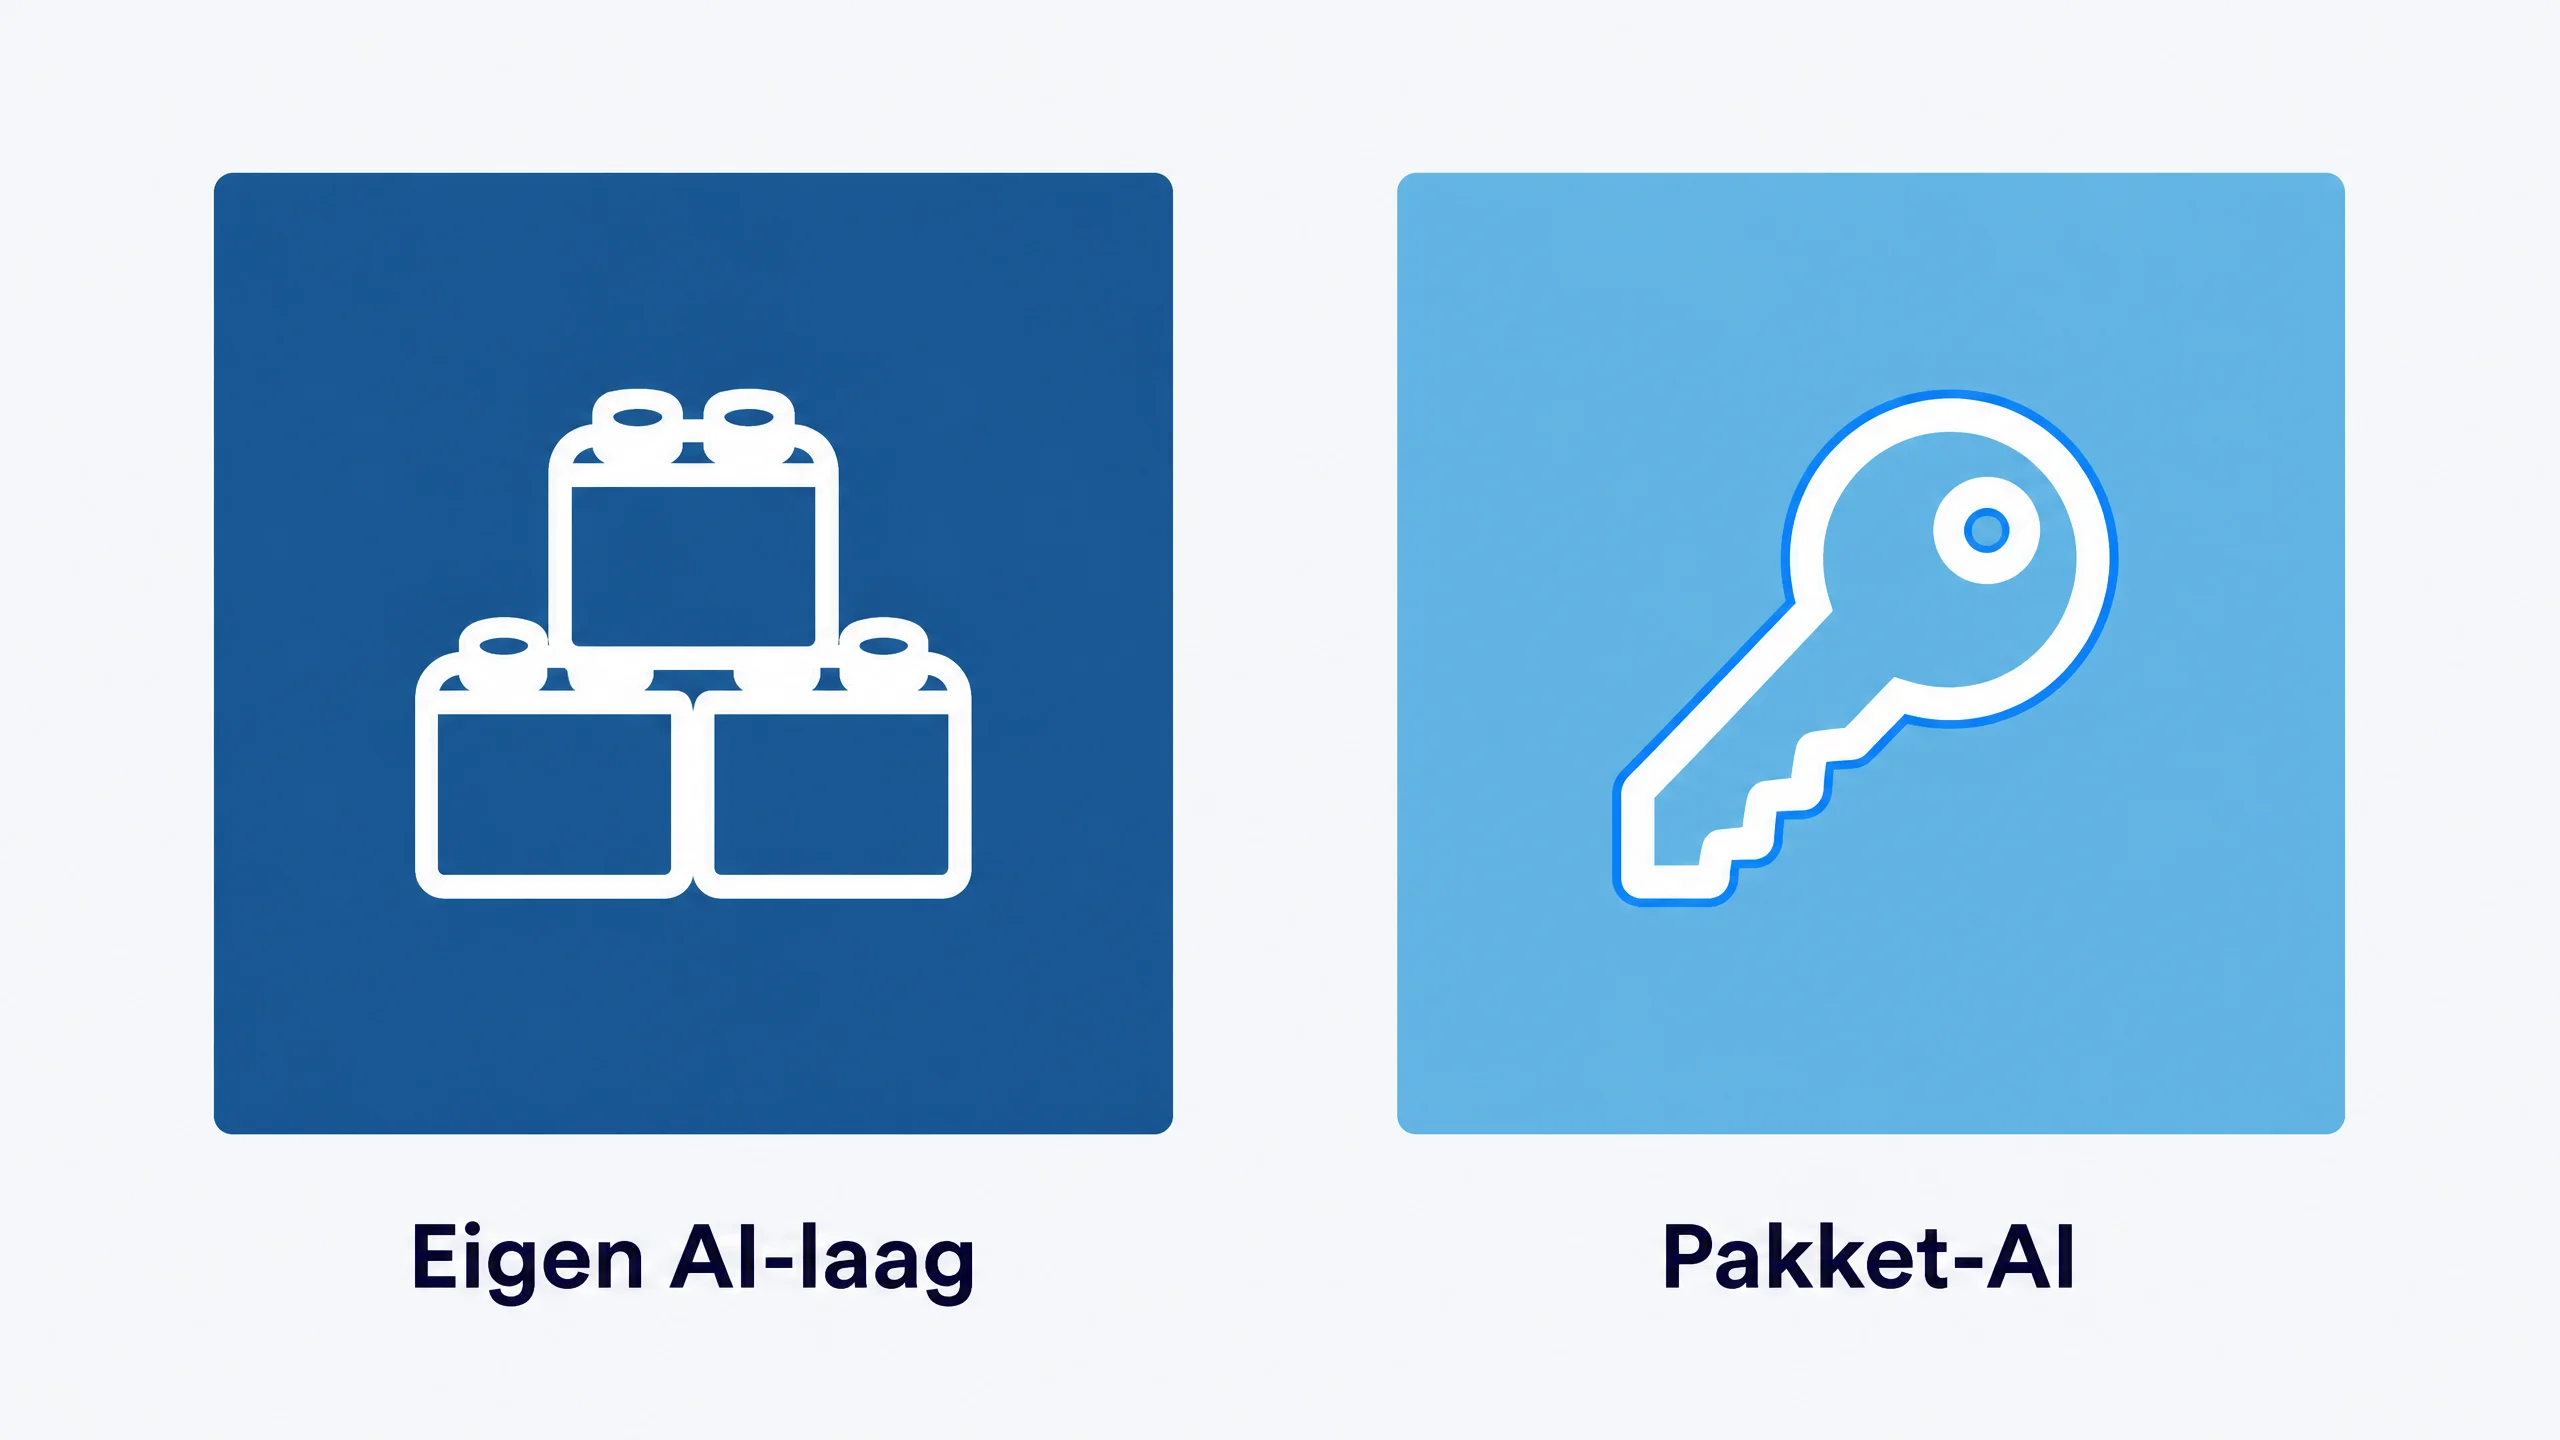
Zodra je AI wilt inzetten naast je bestaande systemen, is er een tweede keuze die los staat van de drie routes hierboven: huur je AI als onderdeel van je bestaande pakket, of bouw je een eigen AI-laag?
De kostenstructuur verschilt ook. Pakket-AI reken je meestal per gebruiker per maand, een vast bedrag dat meegroeit met je personeelsbestand, ongeacht hoeveel die AI daadwerkelijk wordt gebruikt. Een eigen AI-laag reken je per uitgevoerde taak of per proces, wat bij een klein team vaak goedkoper uitpakt zodra je eenmaal voorbij de bouwkosten bent.
Deze keuze is niet alleen technisch, hij is strategisch. Onderzoek van het NANDA-initiatief van MIT, aangehaald door Fortune, laat zien dat samenwerken met gespecialiseerde AI-partners ongeveer twee keer zo vaak slaagt als een volledig interne bouw (Fortune, augustus 2025). Dat pleit niet tegen eigendom van je AI-laag, het pleit tegen in je eentje opnieuw het wiel uitvinden.
Wil je begrijpen waarom pakket-AI structureel vastloopt zodra je buiten het eigen ecosysteem van de leverancier werkt? Lees onze analyse van de fundamentele beperkingen van AI-agents binnen legacy SaaS.
Pakket-AI is snel, maar eindigt waar het pakket eindigt. Een eigen AI-laag kost meer vooraf, maar eindigt nergens.
Een eigen AI-laag is geen upgrade die voor elk bedrijf logisch is. Hij is alleen de juiste keuze onder één voorwaarde: je hebt de ambitie om AI als eigen capability binnen je organisatie te bouwen, niet als los extraatje bovenop bestaande software.
Heb je die ambitie niet, dan is pakket-AI vaak gewoon het verstandigere antwoord. Niets mis met Microsoft 365 Copilot of Agentforce als je AI vooral wilt gebruiken om bestaande taken sneller te doen, zonder dat je een eigen team wilt opbouwen dat die laag onderhoudt.
Twijfel je of je systeemlandschap sowieso klaar is voor een integratietraject, los van de AI-keuze? Lees eerst wanneer je systeemintegratie-consultancy nodig hebt (en wanneer niet), dat beslissingskader staat los van wat hierboven staat.
Herken je vooral het ERP-specifieke pijnpunt, overtypen tussen een branchepakket en de rest van je systemen? Dan is ERP-integratie zonder copy-paste de meer specifieke ingang voor dat ene proces.
Wij noemen een volledig gekoppeld systeemlandschap waar een AI-agent op kan vertrouwen een AI-bedrijfsbrein: geen doel op zich, maar het fundament waarop de volgende stap, of dat nu een digitale medewerker of een nieuw proces is, kan blijven staan.
De juiste vraag is niet "kunnen wij dit bouwen", het is "willen wij AI als eigen capability bezitten, of huren we liever wat een ander al gebouwd heeft". Beide antwoorden zijn geldig, zolang je bewust kiest in plaats van toevallig in een route te rollen.
Omdat het de enige praktische manier was om data uit meerdere systemen op één plek bruikbaar te maken. Synchronisatie bespaarde mensen tijd die ze anders kwijt waren aan overtypen en opzoeken. Het probleem is niet synchronisatie zelf, maar dat het voor veel bedrijven het doel werd in plaats van het middel.
Bij synchroniseren kopieer je data vooraf naar een centrale plek, zodat die altijd klaarstaat maar ook kan verouderen. Een AI-agent die live bij de bron ophaalt, vraagt de data pas op het moment dat hij die nodig heeft, via tool calling. Dat scheelt onderhoud, maar maakt je wel afhankelijk van de beschikbaarheid van de bron zelf.
Vooraf meestal wel: je bouwt koppelingen en governance die een kant-en-klaar pakket al meelevert. Op de lange termijn hangt het af van hoeveel systemen je wilt verbinden en hoe belangrijk eigendom en onafhankelijkheid voor je zijn. Pakket-AI is goedkoper om te starten, een eigen AI-laag is goedkoper om op te schalen. Reken bij een eigen AI-laag ook de tijd mee die het kost om governance en toezicht in te richten, dat hoort bij de bouwkosten, niet bij een losse post achteraf.
Bij hoogfrequente of hoog-volume workloads waar latency en kosten per aanroep gaan opspelen, bij data die je blijvend in eigen beheer wilt houden, en bij datastromen die al jaren stabiel en bewezen draaien. In die drie gevallen is een vaste koppeling nog steeds de verstandigste keuze.
Het resultaat is niet-deterministisch: dezelfde vraag kan net iets anders beantwoord worden. De actualiteit hangt volledig af van de bron zelf, elke uitvoering kost geld, en je moet vanaf de eerste dag nadenken over governance en toezicht, niet pas als er iets misgaat. Daarom werkt Route C het best op processen waar een net iets ander geformuleerd antwoord geen schade aanricht, en minder goed op processen waar één verkeerd cijfer meteen een factuur of een contract raakt.
MCP staat voor Model Context Protocol, een open standaard om AI-systemen te koppelen aan externe tools en databronnen. Omdat de standaard inmiddels is ondergebracht bij de Linux Foundation, bezit geen enkele softwareleverancier hem alleen. Dat betekent dat een koppeling die je vandaag bouwt, morgen ook met een ander AI-model blijft werken.
Meestal sneller dan bij Route A of B, omdat je geen synchronisatie hoeft op te zetten voordat je iets kunt testen. Een eerste werkend voorbeeld op één proces is binnen enkele weken haalbaar. Opschalen naar meerdere processen en systemen vraagt vervolgens wel bewuste governance.
Voor bedrijven zonder de ambitie om AI als eigen capability te bouwen en te onderhouden. Wil je AI vooral gebruiken om bestaande taken sneller te doen, zonder dat je er een team op wilt zetten, dan is pakket-AI zoals Copilot of Agentforce meestal de verstandigere en snellere route.
Een eigen AI-laag is geen big bang en geen leveranciersgok. Begin met één proces, bewijs het in weken, en bouw verder op een fundament dat blijft staan.
Bekijk Business Apps & Integrations


